
نمونهگیری: چشیدن سوپ (Sampling)
چطور یه نمونهی تصادفی کوچیک میتونه میلیونها نفر رو توصیف کنه، و چرا یه نمونهی خیلی بزرگ که غلط انتخاب شده نمیتونه.
از کی میپرسی
جامعه و نمونه
جامعه (population) یعنی همهی کسایی که میخوای دربارهشون بدونی: همهی بزرگسالهای یه کشور، همهی مشتریهای یه مغازه، همهی لامپهایی که یه کارخونه این هفته ساخته. نمونه (sample) اون بخشیه که واقعاً اندازه میگیری. تقریباً هیچوقت کل جامعه رو اندازه نمیگیری، چون خیلی گرون یا خیلی طولانیه. پس سؤال اصلی همیشه اینه: این نمونه شبیه جامعه هست یا نه؟
یه نظرسنج میخواد بدونه همهی ۶۰ میلیون بزرگسال یه کشور چی فکر میکنن، و به ۱٬۰۰۰ نفرشون زنگ میزنه. اون ۶۰ میلیون جامعهان؛ اون ۱٬۰۰۰ نفر نمونه.
یه قاشق از یه قابلمهی همزده
برای فهمیدن نمکِ سوپ کل قابلمه رو سر نمیکشی؛ یه قاشق کافیه. ولی فقط اگه سوپ رو هم زده باشی. از روی یه قابلمهی همنزده بچشی، شاید فقط آبگوشتش بیاد و نمکش نه، هر چقدر هم قاشقت بزرگ باشه. نمونه هم همینطوره: یه نمونهی کوچیک میتونه یه جامعهی خیلی بزرگ رو توصیف کنه، اگه طوری انتخاب شده باشه که همه رو منصفانه قاطی کنه.
خودت رو امتحان کن
یه دانشگاه میخواد بدونه ۲۰٬۰۰۰ دانشجوش چقدر راضیان، و یه پرسشنامه برای ۵۰۰ نفرشون ایمیل میکنه. جامعه اینجا کیه؟
- همون ۵۰۰ دانشجویی که ایمیل گرفتن
- همهی ۲۰٬۰۰۰ دانشجوی دانشگاه
- همهی دانشجوهای کشور
- دانشجوهایی که جواب ایمیل رو میدن
جواب رو ببین
همهی ۲۰٬۰۰۰ دانشجوی دانشگاه
درسته. جامعه یعنی همهی کسایی که دانشگاه میخواد دربارهشون بدونه: هر ۲۰٬۰۰۰ دانشجوش. اون ۵۰۰ نفر نمونهان، و کسایی که جواب میدن یه گروه کوچیکترن.
قدمبهقدم ببین
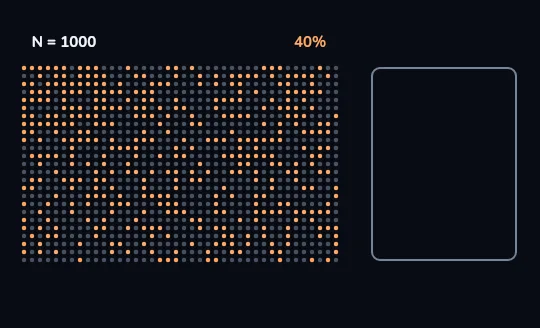
یه شهر ۱٬۰۰۰ نفره یه شهر ۱٬۰۰۰ نفره، هر نفر یه نقطه، با برچسب N = 1000. نقطههای نارنجی، ۴۰۰ تا یعنی ۴۰ نفر از هر ۱۰۰ نفر، چای رو ترجیح میدن؛ خاکستریها نه. جعبهی خالیِ سمت راست منتظر یه نمونهست.
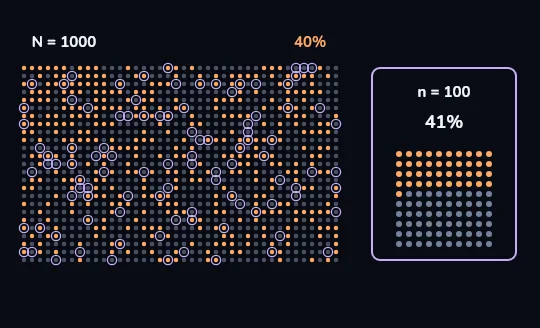
۱۰۰ نفر تصادفی: نمونه میگه ۴۱٪ صد نفر که همهجای شهر پخشن، دورشون یه حلقهی بنفش کمرنگ کشیده میشه و میرن توی جعبه، با برچسب n = 100. جوابهاشون مرتب چیده شده، اول نارنجیها: ۴۱٪ نمونه چای رو ترجیح میدن، نزدیک همون ۴۰٪ واقعی.
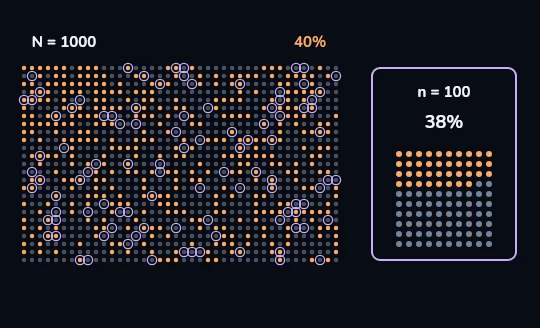
نمونههای تصادفی تازه، جوابهای تازه حلقهها مدام میپرن روی ۱۰۰ نفر تصادفیِ تازه، و جعبه اول ۳۸٪ نشون میده، بعد ۴۳٪، بعد ۴۰٪، بعد ۴۱٪. هر نمونهی تصادفی یهکم متفاوت درمیاد، ولی همیشه نزدیک ۴۰٪. به این بالا پایین رفتن میگن خطای نمونهگیری.
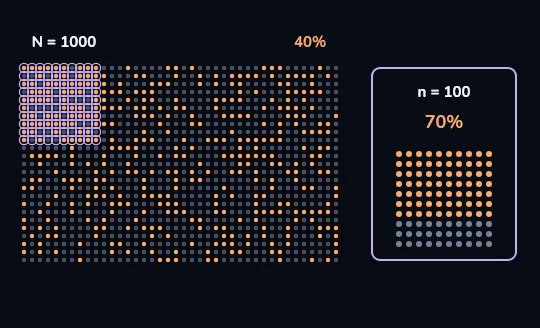
فقط از یه گوشه بپرس: ۷۰٪ حالا هر ۱۰۰ نفر از یه گوشه انتخاب شدن، بلوک بالا سمت چپِ شبکه، جایی که چایدوستها اتفاقاً دور هم جمع شدن. جعبه با رنگ نارنجی ۷۰٪ نشون میده، درحالیکه عدد واقعی ۴۰٪ـه. این یه نمونهی سوگیرانهست، و پرسیدن از آدمهای بیشتر از همون گوشه درستش نمیکنه.
خودت رو امتحان کن
نظرسنجی آنلاین یه سایت خبری ۵۰٬۰۰۰ رأی میگیره. یه مؤسسهی نظرسنجی از ۱٬۰۰۰ بزرگسال بهطور تصادفی نمونه میگیره. کدوم بهتر نشون میده کشور چی فکر میکنه؟
- نظرسنجی سایت خبری، چون ۵۰٬۰۰۰ نفر خیلی بیشتره
- همون ۱٬۰۰۰ نفر تصادفی، چون همه شانس منصفانهای برای انتخاب شدن داشتن
- هر دو به یه اندازه، چون هر نظرسنجی بالای ۱٬۰۰۰ نفر قابل اعتماده
جواب رو ببین
همون ۱٬۰۰۰ نفر تصادفی، چون همه شانس منصفانهای برای انتخاب شدن داشتن
درسته. اون ۵۰٬۰۰۰ نفر خوانندههای همون سایتن که خودشون خواستن رأی بدن؛ یه گوشه از کشور، مثل گوشهی بالا چپِ شبکه. ۱٬۰۰۰ نفر تصادفی همون یه قاشق از سوپ همزدهست.
نمونهگیری تصادفی (Random Sampling)
انتخاب نمونه طوری که هر عضو جامعه یه شانس مشخص، و ترجیحاً برابر، برای انتخاب شدن داشته باشه. این نسخهی آماریِ هم زدن قابلمهست. اونوقت نمونه معمولاً شبیه جامعه درمیاد، و خطاهایی که میمونن تکونهای کوچیکِ شانسیان که بهشون میگن خطای نمونهگیری (sampling error) و اندازهشون قابل پیشبینیه. درس ۵ اندازهش رو میگیره.
نمونههای تصادفیِ ۱۰۰ نفره از شهر ما ۳۸٪، ۴۳٪، ۴۰٪ و ۴۱٪ دادن، وقتی عدد واقعی ۴۰٪ بود: هیچوقت دقیق نه، همیشه نزدیک.
خودت رو امتحان کن
با اینکه میلیونها جواب داشت، چی باعث شد نظرسنجی Literary Digest سال ۱۹۳۶ اشتباه کنه؟
- تعداد جوابها خیلی کم بود
- یه نمونهی سوگیرانه: اینکه کی توی فهرستهاش بود، و کی خودش خواست جواب بده
- رأیدهندههای روزولت به مجله دروغ گفتن
- مجله رأیها رو اشتباه جمع زد
جواب رو ببین
یه نمونهی سوگیرانه: اینکه کی توی فهرستهاش بود، و کی خودش خواست جواب بده
درسته. فهرستهاش به سمت آدمهای پولدارتر کج بود، و کسایی که جواب دادن هم باز فرق داشتن. میلیونها جواب از یه گوشهی کج، باز یه جواب کج میده.
خودگزینی (Self-selection)
وقتی آدمها خودشون انتخاب میکنن که توی نمونه باشن یا نه. نظرسنجیهای آنلاین، رأیگیریهای تلفنی و فرمهای «به ما امتیاز بده» بیشتر صدای پرانگیزهترها، خیلی راضیها یا خیلی عصبانیها رو میشنون. نتیجهشون کسایی رو توصیف میکنه که جواب دادن، نه مردم رو. این یه نوع سوگیری نمونهگیری (sampling bias)ـه: هر روشی که بعضیها رو به بقیه ترجیح بده.
صفحهی نظرهای یه رستوران پر از امتیاز ۱ و ۵ ستارهست. اون همه مشتریای که به نظرشون معمولی بود، بهندرت زحمت نوشتن چیزی رو به خودشون میدن.
خودت رو امتحان کن
اگه یه نمونه سوگیرانه باشه، دو برابر کردن اندازهش سوگیری رو از بین میبره.
جواب رو ببین
نادرست
غلطه. آدمهای بیشتر به همون روش، فقط همون کجی رو دقیقتر تکرار میکنن. پرسیدن از ۲۰۰ نفر توی همون گوشهی پرچای، باز حدود ۷۰٪ میده، نه ۴۰٪. فقط عوض کردنِ روشِ انتخاب، سوگیری رو درست میکنه.
دو سوگیری دیگه که ارزش اسم بردن دارن
عدم پاسخ (Non-response)
کسایی که جواب نمیدن با کسایی که جواب میدن فرق دارن. اگه پدر و مادرهای پرمشغله و کارگرهای شیفت شب هیچوقت تلفن رو جواب ندن، نظرسنجی دربارهی وقت آزاد صدای کسایی رو میشنوه که بیشترین وقت آزاد رو دارن.
سوگیری بقا (Survivorship)
فقط اونایی رو میبینی که موندن. «ساختمونهای قدیمی محکمتر ساخته میشدن» همهی ساختمونهای قدیمیای رو که ریختن یا خراب شدن نادیده میگیره؛ فقط محکمها هنوز سرپان که ازشون تعریف کنیم.
خودت رو امتحان کن
یه باشگاه از اعضای خودش نظرسنجی میکنه، میبینه ۹۰٪ هر هفته ورزش میکنن، و اعلام میکنه «۹۰٪ مردم این شهر هر هفته ورزش میکنن». اشکالش چیه؟
- هیچی، ۹۰٪ نتیجهی روشنیه
- نمونه اعضای باشگاهن، نه جامعهی شهر که ادعا میکنه توصیفش کرده
- باشگاه باید از اعضای کمتری میپرسید
- ورزش هفتگی رو نمیشه با نظرسنجی اندازه گرفت
جواب رو ببین
نمونه اعضای باشگاهن، نه جامعهی شهر که ادعا میکنه توصیفش کرده
درسته. اعضای باشگاه دقیقاً همون کساییان که بیشتر از همه احتمال داره ورزش کنن. نتیجه شاید دربارهی اعضا درست باشه، ولی جامعهای که ادعا دربارهشه، یعنی همهی مردم شهر، اصلاً نمونهگیری نشده.
چهار سؤال برای هر نظرسنجی
- از کی پرسیدن؟
این گروه با جامعهای که تیتر دربارهش حرف میزنه جوره، یا فقط یه گوشهشه؟
- چطور انتخاب شدن؟
تصادفی، یا خودشون داوطلب شدن، روی یه لینک زدن یا اتفاقی اون دور و بر بودن؟
- چند نفر جواب دادن؟
نرخ پاسخ پایین یعنی جوابها شاید از یه تیکهی غیرعادی از آدمهایی باشه که ازشون پرسیدن.
- کی جا مونده؟
کسایی که اینترنت ندارن، کسایی که نموندن، کسایی که وقت جواب دادن نداشتن. ممکنه اونا جواب دیگهای میدادن؟
مرور درس
- جامعه یعنی همهی کسایی که میخوای دربارهشون بدونی؛ نمونه بخشیه که واقعاً اندازه میگیری.
- نمونهی تصادفی یه قاشق از سوپ همزدهست: توی شهری که ۴۰٪ چای دوست دارن، نمونههای تصادفی ۱۰۰ نفره هر بار نزدیک ۴۰٪ درومدن.
- سوگیری نمونهگیری، مثل پرسیدن فقط از یه گوشه، ۷۰٪ داد، و پرسیدن از آدمهای بیشتر به همون روش درستش نمیکنه.
- نظرسنجی Literary Digest سال ۱۹۳۶ حدود ۲٫۴ میلیون جواب داشت و باز برنده رو اشتباه گفت؛ بزرگی حریف سوگیری نشد.
- حواست به خودگزینی، عدم پاسخ و سوگیری بقا باشه، و بپرس از کی پرسیدن، چطور، چند نفر جواب دادن و کی جا مونده.